
KI, die Ihnen gehört.
Wie integrieren Sie KI in Ihrem Unternehmen — und wie bauen Sie sich eine eigene, lokale KI auf, bei der die Daten im Haus bleiben? Was brauchen Sie dafür, was kostet es, und worin unterscheiden sich die Apple- und die NVIDIA-Welt? Hier ist der Überblick aus der Praxis. Plus ein Konfigurator für Ihr passendes Setup.
Der Splitter-Effekt: jeder Account ein neues Silo.
Jedes KI-Tool bringt seinen eigenen Login mit — Microsoft für Outlook und Exchange, Gemini über ein Google-Konto, ChatGPT und Anthropic jeweils eigenständig. Ohne Integration bauen Sie mit jedem Account ein weiteres Silo: Wissen, Chats und Daten verteilen sich auf Inseln, die nichts voneinander wissen.
Was Sie eigentlich wollen: mit einer Firmen-Identität auf alles zugreifen — interaktiv und in sync, egal ob Microsoft- oder Google-Welt.
Eine Identität
Ein Firmen-Login (SSO) statt vieler Einzel-Accounts — ein Zugang zu allen Tools, sauber verwaltet.
Eine Datenbasis
Alles läuft in ein gemeinsames Daten-Fundament — bis hin zum Data Lake, aus dem KI echten Wert zieht und die Firma lernt.
Guardrails & Prozesse
Klare Regeln, KI-Guardrails (wer darf was, welche Daten — pseudonymisiert) und Prozesse, um das sicher zu betreiben.
Das ist Core-Arbeit: Integration als Synapsen, eine souveräne Datenbasis und ein AI-Gateway als Guardrail — betrieben auf sauberen Prozessen.
Cloud oder souverän — oder beides.
Es gibt zwei grundsätzliche Wege, KI ins Unternehmen zu bringen. Welcher passt, hängt vor allem davon ab, wie sensibel Ihre Daten sind.
Cloud-KI
Schnell startklar, stärkste Modelle, kein eigener Betrieb. Ihre Daten verlassen aber das Haus — ideal für unkritische Fälle und den Einstieg.
Souveräne lokale KI
Daten bleiben bei Ihnen, volle Kontrolle, planbare Kosten. Mehr Aufbau — dafür unabhängig, auditfest und dauerhaft günstiger im Betrieb.
Wie weit wollen Sie gehen?
Von „heute die Cloud nutzen" bis zur eigenen, trainierten KI — fünf Stufen, die aufeinander aufbauen. Sie können auf jeder einsteigen.
Claude oder GPT per Schnittstelle in Ihre Tools — keine eigene Infrastruktur, sofort produktiv.
Ihre Dokumente werden durchsuchbar gemacht (Embeddings + Vektor-DB). Antworten mit Quellen, statt Halluzinationen.
Ein Open-Weight-Modell läuft via Ollama auf eigener Hardware. Anfragen verlassen den Standort nicht.
Mehrere Modelle, viele Nutzer, hoher Durchsatz — auf NVIDIA-GPUs oder einem Apple-Silicon-Cluster.
Eigene Daten antrainieren, Modelle versionieren, betreiben und überwachen — KI als verlässlicher Teil des Betriebs.
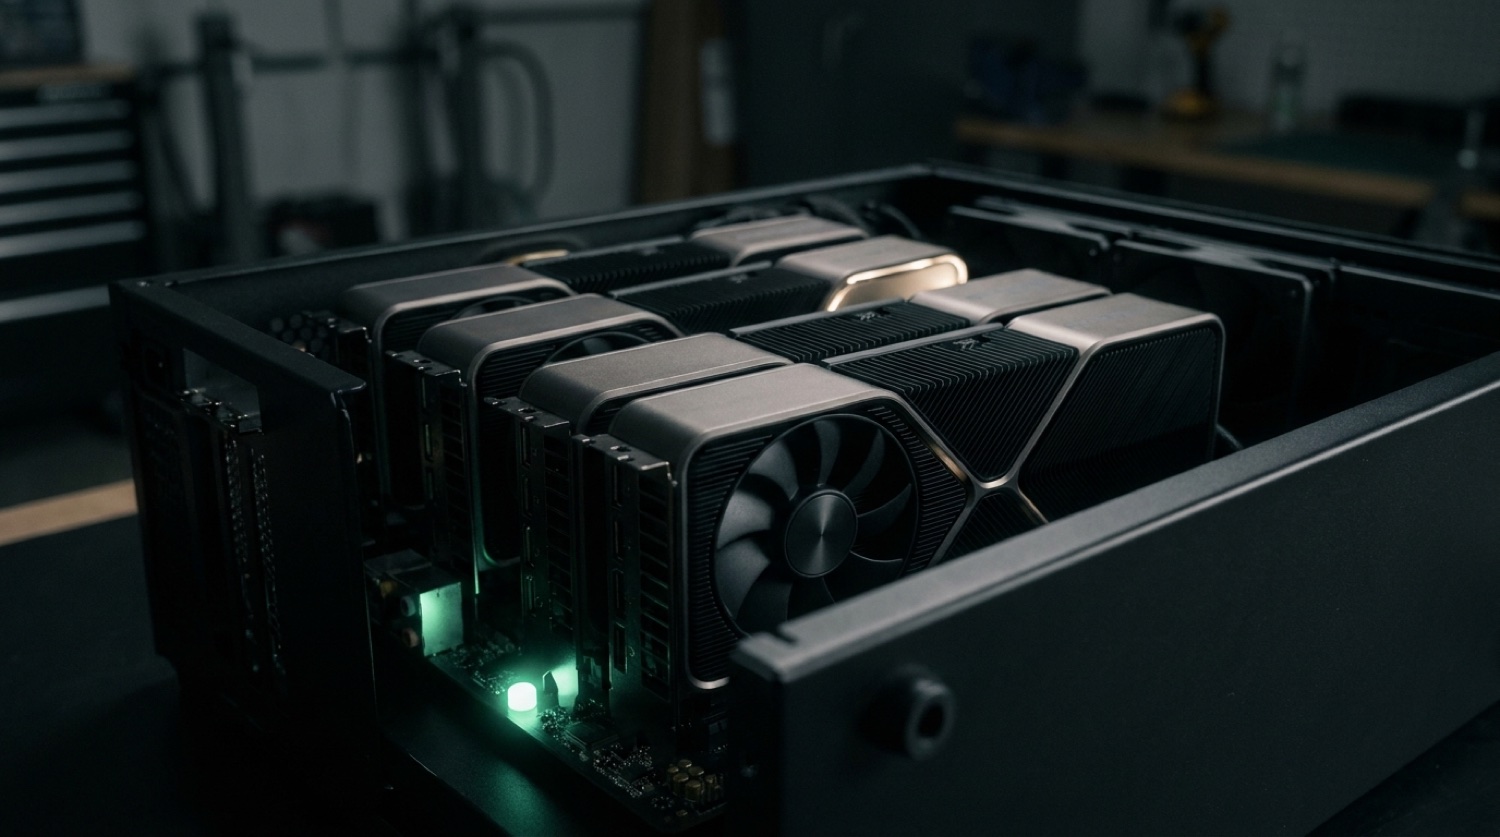
Apple Silicon vs. NVIDIA.
Für lokale KI gibt es zwei Hardware-Welten. Sie lösen dieselbe Aufgabe sehr unterschiedlich — und die Wahl entscheidet über Kosten, Strom und Skalierung.
Welche KI passt zu Ihnen?
Wählen Sie, wie Sie arbeiten und wie sensibel Ihre Daten sind — wir empfehlen Ihnen live das passende KI-Setup samt Komponenten.
Was ein Junior überspringt — und Sie brauchen.
Wer nur Claude nutzt, sieht die Spitze des Eisbergs. Für eine eigene KI brauchen Sie das, was darunter liegt. Die wichtigsten Begriffe in einem Satz:
Das fertige Modell anwenden, also Antworten erzeugen. Genau das, was Claude live tut.
Ein Modell von Grund auf lernen lassen — extrem rechenintensiv und für die meisten Unternehmen unnötig.
Ein fertiges Modell auf Ihre Daten und Ihren Stil nachschärfen, oft sparsam per LoRA-Adapter.
Retrieval-Augmented Generation: Das Modell holt sich Wissen aus Ihren Dokumenten, statt es auswendig zu können.
Texte werden zu Zahlen-Vektoren, damit die KI Ähnliches findet — die Grundlage von RAG.
Neuronale Netze, die Muster aus Daten lernen — das Fundament moderner KI.
Daten sammeln, säubern, aufbereiten. Der grösste Teil der echten Arbeit — und das, was beim blossen Claude-Nutzen übersprungen wird.
Modelle betreiben wie Software: Versionierung, Deployment, Monitoring und Kostenkontrolle.
Kurz beantwortet.
Was brauche ich, um KI im Unternehmen selbst aufzubauen?
Hardware (NVIDIA-GPUs oder Apple Silicon), ein Open-Weight-Modell, Inferenz-Software wie Ollama oder vLLM, für eigenes Wissen eine Vektor-Datenbank mit RAG — und jemanden, der es betreibt (MLOps). Der Einstieg gelingt schon mit einer einzelnen Workstation; für viele Nutzer kommt ein Cluster dazu.
Lohnt sich eine lokale KI gegenüber der Cloud?
Wenn Ihre Daten das Haus nicht verlassen dürfen, die Kosten planbar sein müssen oder Sie unabhängig sein wollen: ja. Für unkritische Aufgaben ist die Cloud schneller und liefert die stärksten Modelle. Häufig ist eine Mischung aus beidem am sinnvollsten.
Apple Silicon oder NVIDIA für lokale KI?
Apple Silicon mit Unified Memory lädt grosse Modelle günstig, leise und stromsparend — ideal für Inferenz und sensible Daten am Standort. NVIDIA mit CUDA liefert maximale Leistung für Training, Fine-Tuning und hohen Durchsatz. Für reine Inferenz reicht oft Apple, fürs Training nimmt man NVIDIA.
Was ist ein lokales Sprachmodell?
Ein Open-Weight-LLM wie Llama, Mistral oder Qwen, das Sie selbst auf eigener Hardware betreiben — ohne dass Anfragen an einen Cloud-Anbieter gehen. Sie können es per RAG um Ihr Wissen erweitern und per Fine-Tuning anpassen.
Brauche ich dafür ein eigenes Data-Science-Team?
Für den Einstieg nicht — ITM richtet die KI ein und betreibt sie. Wer tiefer geht, etwa mit Fine-Tuning und eigenen Pipelines, braucht MLOps-Know-how; das bringen wir mit oder bauen es gemeinsam mit Ihrem Team auf.
Wir bauen Ihre souveräne KI.
Von der Cloud-Anbindung über RAG auf Ihren Daten bis zum eigenen Apple- oder NVIDIA-Cluster — ITM plant, baut und betreibt Ihre KI. Daten bleiben bei Ihnen.